Продуктовый аналитик: Путешествие туда и обратно
Глава 4. Глубина познания в Пещере Оракула
4.3. Машинное обучение как ваш Гримуар Големов
За залом Священного ритуала полог из мерцающих капель скрывает низкий проход. Вы уже слышали от старших жрецов, что там когда-то жил странный волшебник. Обычным жрецам туда ходить не принято, ведь тем, кто умеет говорить с Оракулом, редко нужно что-то ещё. Но мастерская волшебника как будто зовёт вас. Внутри тесной мастерской, заваленной обломками недособранных глиняных фигур, вы видите на столе тяжёлую книгу в толстом переплёте. На обложке ни названия, ни автора, только символ змеи. Гримуар Големов открывается сам на первой странице, а на ней уже проступают слова, написанные будто вашей же рукой.
-Место машинного обучения в продуктовом цикле
-Бинарная классификация, LightGBM, PR-AUC
-Аппроксимация кривой LTV
-Кластеризация игроков, k-means
-Квазиэксперименты, CausalImpact
-Прогноз временных рядов, Prophet
-ИИ в работе аналитика
4.3.1. Магия машинного обучения
На первой странице Гримуара вы видите тайные имена големов, зашифрованные в виде вопросов, которые книга задаёт прежде, чем что-то оживить: «Что я хочу узнать про игрока, которого ещё не видел?», «Что общего есть у этих игроков?», «Что случилось бы, если бы я не изменил прошлое?», «Что будет завтра, если ничего не изменить сейчас?». Каждый вопрос ведёт на свою страницу в Гримуаре.
Задачи аналитика, встроенные в продуктовый цикл, строятся на ваших наблюдениях, исследованиях, сегментациях, когортах и воронках, поиске аномалий. Ранее в главе Искусство глубоких исследований мы подробно рассмотрели продуктовый цикл.
Метрики → Анализ → Вывод → Концепция решения → Действие → Оценка результата
   ↑                                                              |
   └──────────────────────────────────────────────────────────────┘
Алгоритмы машинного обучения и ИИ могут существенно усилить вас не только с A/B-тестами в заключительном звене цикла (оценке результатов), но и на этапах «Анализа» и «Выводов» (LTV, сегментация, прогнозы) и даже помочь с фазой «Действия» через продуктовые решения: персонализированные предложения, умные рекомендации, тесты логов. Именно усилить, а не заменить. Создаваемый вами при помощи кода «Голем» не придумывает гипотезу и не решает за вас какую фичу катить, он выполняет конкретную, заранее сформулированную вами задачу прогноза или поиска структуры внутри данных, которые вы ему даёте.
Важно, что эта глава не заменит вам полноценный учебник по Data Science, мы не будем глубоко разбирать математику работы каждого из этих прекрасных творений. И я намеренно оставил за скобками обработку естественного языка (NLP) для анализа обращений в поддержку, генерацию картинок или видео. Мы разберём тот базовый набор алгоритмов и подходов, которого хватает для закрытия подавляющего большинства продуктовых аналитических задач в геймдеве. Не знаю как в итоге вас, но меня всегда вдохновляло с какой легкостью вы научитесь сегодня запускать невероятно крутые библиотеки, созданные современными учеными по данным, настоящими волшебниками современности. В этой главе вы откроете «Гримуар создания Големов» и узнаете как предсказывать кто заплатит, прогнозировать LTV, находить закономерности и общности в данных, оценивать эффект там, где A/B-тест невозможен, и заглядывать в ближайшее будущее метрик. А в конце вы встретите Голема-Собеседника самого полезного из всех, и самого коварного в том, как незаметно он умеет менять того, кто с ним работает.
Но, прежде чем лепить первого «Голема» рационально оцените необходимость таких усилий. Возможно, если вашу задачу можно закрыть простым бизнес-правилом («игрок не заходил семь дней подряд, то считаем это склонностью к уходу из игры») или ручным аналитическим срезом («наш VIP-сегмент это топ-5% по платежам за первую неделю»), то не спешите «использовать магию» машинного обучения. «Голем» оправдан там, где закономерность неочевидна человеческому глазу, где признаков десятки и их взаимодействие нелинейно, и где задача повторяется достаточно часто, чтобы окупить стоимость постройки и содержания «Голема».
4.3.2. Кем будет каждый игрок
Вы открыли страницу рецепта Голема-Предсказателя судеб: «Прежде чем лепить, подготовь глину и трижды зачерпни воду из Озера Оракула, где отражались множества непохожих судеб. Из первой порции будешь строить Голема. Вторую используй, чтобы улучшить свою работу. Третью спрячь и не трогай, пока не закончишь: по ней оценишь получившегося Голема».
Если в F2P деньги дают примерно 2–5% пользователей, то один платящий игрок компенсирует стоимость привлечения многих неплатящих, каждый из которых при этом стоит в закупке порядка 200–2000 рублей. Но если за покупку рекламы мы платим сразу при привлечении игроков в игру, то окупаемость трафика это область наших ожиданий, которые могут и не оправдаться, а узнаём мы об этом примерно через год после того, как деньги потрачены. Отсюда рождается классическая, фундаментальная задача продуктовой аналитики в геймдеве: прогнозирование конверсии в плательщика на ранних этапах жизни игрока. Маркетингу и команде продукта критично важно знать прямо сейчас не тратим ли мы деньги впустую, и приходят ли к нам сейчас те, кто будет платить в будущем, и кто они.
Если свести эту задачу к математической формулировке, то нам необходима модель бинарной классификации, на вход которой мы подаём набор признаков игрока (фичей, features), собранных за фиксированный стартовый период (например, первые 1–3 дня с момента первого входа), и рассчитываем вероятность того, что этот игрок совершит хотя бы один платёж к заданному дню жизни (например, с 3 по 30). Если полученная вероятность выше некоторого порога (threshold), мы присваиваем игроку метку 1 (будущий плательщик), если ниже, то метку 0 (неплательщик).
Как вы помните из прошлой главы про A/B-тесты, для стратификации выборок мы выбирали ключевые признаки (ковариаты), которые предопределяют характер взаимодействия с нашим воздействием (treatment), из-за чего ключевая метрика должна сильно измениться. Эти ковариаты по смыслу как раз похожи на выбираемые нами фичи для алгоритма машинного обучения, только фичей можно сделать гораздо больше. Что именно выбрать в качестве таких фичей мы уже разбирали в главах почему люди играют и почему платят. На основе этих знаний выбираем признаки внутри исторического окна наблюдения (первые три дня, D1-3), по которым мы ожидаем заметной разницы между теми, кто будет платить и теми, кто не будет. Для реального Data Scientist, возможно, это самая творческая часть всего рабочего процесса.
1. Статичные признаки такие как платформа и устройство (например, бюджетный смартфон или флагман могут косвенно указывать на платежеспособность), гео и регион (в разных странах разный уровень жизни), маркетинговый источник (нецелевой трафик обычно ведет себя хуже).
2. Поведенческие признаки ранней вовлечённости. Игроку незачем платить в игре, если он не собирается в неё играть. Поэтому поведенческие метрики вовлеченности крайне важны. Это могут быть, например, глубина погружения в механики в течение первой сессии, распределение по длине сессий и их частота, игровая активность и прогресс в туториале.
3. Экономическое и психологическое состояние игрока. Это могут быть метрики, характеризующие дефицит или избыток ресурсов и различных видов внутриигровой валюты, история трат, взаимодействие с магазином и платными паками, даже в тех случаях, когда сама покупка ещё не состоялась.
После того как фичи по игрокам собраны, а по каждому игроку известно реальное значение конверсии (1 или 0), которое мы будем учиться прогнозировать, необходимо разделить весь массив данных (датасет) на три строго изолированные выборки.
1. Обучающая выборка (Train). На этих данных алгоритм (например, градиентный бустинг как один из самых популярных семейств алгоритмов машинного обучения) строит свои внутренние деревья решений. Он учится подбирать веса нашим фичам (степень их влияния на прогноз), находит неочевидные взаимосвязи между признаками и пытается минимизировать ошибку предсказания. Модель видит и признаки (D1–3), и реальные исторические ответы (1 или 0).
2. Валидационная выборка (Validation). Эта выборка используется для сверки. Модель не обучается на этих данных напрямую. Сверяясь с валидационной выборкой, вы:
- подбираете оптимальные настройки алгоритма (гиперпараметры): глубину деревьев, скорость обучения (learning_rate), штрафы за сложность (регуляризацию);
- применяете механизм ранней остановки (Early Stopping): если ошибка на обучающей выборке продолжает падать, а на валидационной начинает расти, значит алгоритм начал переобучаться (зазубривать шум).
3. Отложенная выборка (Holdout). Финальная проверка вашей модели. Модель не должна видеть эти данные ни при обучении, ни при подборе гиперпараметров. Holdout-выборка используется ровно один раз, в самом конце работы, для честной, непредвзятой оценки качества модели перед выпуском в продакшен. Она показывает, как алгоритм справится с игроками, которых он никогда в своей жизни не видел.
Здесь начинающие дата-сайентисты часто совершают концептуальную ошибку и при помощи train_test_split делят данные случайно на три части (например, 70% / 15% / 15%). Но в геймдеве этот подход ведёт к утечке информации (Data Leakage), ведь игра постоянно меняется (новый баланс экономики, добавляют контент, меняют цены) и если перемешать данные случайно, модель обучения и данные для проверки будут содержать разные эпохи жизни игры. Такая модель покажет феноменальные результаты при проверке, потому что при обучении она фактически подсматривала в то же самое «состояние мира» на котором потом проверяется. Поэтому Holdout-выборка отрезается строго по времени (Time-Based Split). Берите исторические данные за прошлые периоды для обучения, а самую свежую когорту (например, игроков последней недели или месяца) используйте как Holdout.
На этапе обучения модель (LightGBM как пример отличной реализации градиентного бустинга над деревьями решений) подбирает решение, оптимизируя функцию потерь (loss function). Для бинарной классификации это функция бинарной кросс-энтропии (binary logloss). Звучит непонятно, но в рамках курса нам не нужно погружаться во все тонкости работы алгоритмов ML и оставим это тем, кто хочет углубиться в Data Science отдельно. Основной смысл использования Log Loss в том, что мы «наказываем Голема» тем сильнее, чем самоувереннее он ошибся в оценке вероятности «заплатит / не заплатит». В итоге предсказать 0,99 там, где игрок не заплатил, гораздо дороже, чем предсказать 0,6.
Вторая распространенная ошибка новичка это учить модель оптимизировать долю верных предсказаний (Accuracy). Но при 5% плательщиков модель, которая всегда говорит «не заплатит», получит accuracy 95% и при этом будет абсолютно бесполезна.
При дисбалансе классов правильнее ориентироваться на две другие метрики: точность и полноту. Точность модели (Precision) показывает, какая доля игроков реально заплатила из тех, кого модель назвала потенциальными плательщиками. Полнота (Recall) показывает, какую долю реальных плательщиков модель поймала. Если в вашей задаче важнее не потерять потенциальных плательщиков и, например, вы формируете список для персонального предложения, и лучше показать его лишнему неплательщику, чем пропустить настоящего плательщика то вам важнее Recall. Если, наоборот, цена ложного попадания высока, например, вы тратите дорогой ретаргетинг-бюджет только на «перспективных» то вам важнее Precision. В общем случае вам будет важен баланс точности и полноты именно для целевого сегмента потенциальных плательщиков. Для этого существует метрика PR-AUC (Area Under the Precision-Recall Curve) которая полностью игнорирует огромное количество неплательщиков и фокусируется исключительно на качестве предсказания целевого класса. Следует сказать, что есть также и более популярная метрика ROC-AUC. Однако, она также учитывает и долю верно угаданных неплательщиков (True Negative Rate), а их в датасете подавляющее большинство. Поэтому ROC-AUC будет выглядеть высоким просто потому, что легко правильно предсказывать многочисленный класс. В то время как PR-AUC полностью фокусируется только на том, насколько хорошо модель находит редкий целевой класс.
Потренируемся с кодом на Python для обучения и проверки нашего предсказателя.
import numpy as np
import pandas as pd
import lightgbm as lgb
from sklearn.metrics import log_loss, average_precision_score, precision_recall_curve, confusion_matrix
Предположим, мы уже отделили выборку holdout для финальной проверки, а в нашем датафрейме есть колонки признаков (FEATURES) и колонка итогового результата (TARGET), содержащая 0 и 1 как метка стал ли игрок плательщиком до с 3 по 30й день. Пока не будем усложнять наш код и делить Train/Val через кросс-валидацию по фолдам (K-Fold), хотя такой подход и снижает вероятность переобучения.
Отделяем колонки фичей от колонки результатов.
X_train, y_train = df_train[FEATURES], df_train[TARGET]
X_val, y_val = df_val[FEATURES], df_val[TARGET]
X_holdout, y_holdout = df_holdout[FEATURES], df_holdout[TARGET]
Превращаем стандартные датафреймы в оптимизированные структуры данных бустинга.
dtrain = lgb.Dataset(X_train, label=y_train)
dval = lgb.Dataset(X_val, label=y_val, reference=dtrain)
Задаём базовые настройки (гиперпараметры) нашей модели. Обратите внимание на scale_pos_weight именно здесь модель узнаёт о дисбалансе классов, возьмем это как 95/5=19.
params = {
'objective': 'binary', бинарная классификация
'metric': 'average_precision', минимизируем метрику
'boosting_type': 'gbdt', градиентный бустинг на деревьях
'learning_rate': 0.03, маленький шаг градиентного спуска
'num_leaves': 31, максимальное количество листьев в одном дереве
'max_depth': 5, ограничиваем глубину, защищаясь от переобучения
'feature_fraction': 0.8, каждое дерево видит только 80% случайных признаков
'scale_pos_weight': 19, дисбаланс классов 95/5=19
'verbose': -1
}
Запускаем обучение.
evals_res = {} словарь, который LightGBM заполнит во время обучения на каждой итерации бустинга
model = lgb.train(
params, словарь гиперпараметров, собрали выше
dtrain, обучающие данные, обёрнутые в lgb.Dataset
num_boost_round=1000, максимальное число деревьев
valid_sets=[dtrain, dval], модель учится на train, но контролирует оптимизацию по val
valid_names=['train', 'val'],
callbacks=[
lgb.early_stopping(stopping_rounds=50, verbose=True), остановка, если 50 итераций подряд нет улучшения
lgb.record_evaluation(evals_res) запись результата на каждой итерации
]
)
Используя лучшую полученную модель, предсказываем вероятность отнесения каждого игрока из X_holdout к плательщикам.
preds_holdout = model.predict(X_holdout, num_iteration=model.best_iteration)
Вычисляем PR-AUC. Здесь есть готовая функция average_precision_score.
holdout_pr_auc = average_precision_score(y_holdout, preds_holdout)
print(holdout_pr_auc) наш результат прогноза на отложенной выборке
Сейчас для наших игроков получены вероятности от 0 до 1, которые необходимо перевести в класс 0 или 1 в зависимости от порогового уровня (threshold). Строго говоря, это не совсем настоящие вероятности стать плательщиком, это некоторые относительные величины такой вероятности, но в самой задаче важен только их относительный порядок. Предположим, тут мы выберем пороговый уровень равный 0,15.
chosen_threshold = 0.15
binary_preds = (preds_holdout >= chosen_threshold).astype(int)
Посмотрим, как точно мы спрогнозировали, используя матрицу ошибок (Confusion Matrix) для выбранного порога.
cm = confusion_matrix(y_holdout, binary_preds)
print(cm[0][0]) верно предсказали, что не заплатят
print(cm[0][1]) предсказали, что заплатят, но ошиблись
print(cm[1][0]) предсказали, что не заплатят, но ошиблись
print(cm[1][1]) верно предсказали, что заплатят
Порог 0,15 мной выбран как компромисс между Precision и Recall, который вы можете изменить под каждую задачу, глядя на кривую precision_recall_curve и на цену ошибки в вашем конкретном случае применения модели.
Бывает, что вам мало обучить Голема-Предсказателя и рано или поздно вас спросят «а почему модель считает именно этого игрока перспективным плательщиком». Здесь нам поможет понятие важности признаков (feature importance), с базовой реализацией прямо в LightGBM.
importance = pd.Series( model.feature_importance(importance_type='gain'), index=FEATURES).sort_values(ascending=False)
print(importance.head(10))
Uplift
Можно использовать полученный результат в связке с вашим решением кому показать промо-акцию или персональное предложение. Мы уже встречали эту задачу раньше в главе почему платят в играх и в главе про A/B-тест на смешанной аудитории. Основная проблема здесь в том, что если вы дадите скидку игроку с высокой предсказанной вероятностью платежа, вы, скорее всего, просто продадите дешевле то, что купили бы и без скидки.
Перед показом акции наших игроков хорошо было бы разделить на 4 группы.
1.«Уже готовые» (Sure Things). Заплатят в любом случае, с промо или без, а значит сделав им скидку вы просто снизили себе ARPPU.
2.«Потерянные» (Lost Causes). Не заплатят никогда, ни с промо, ни без. Давать им скидку не имеет смысла, но и безвредно.
3.«Восприимчивые» (Persuadables). Не заплатят без скидки, но заплатят, если ее получат. Именно для них стоит проводить акцию.
4.«Раздражительные» (Do-not-disturb). Заплатили бы, если бы их оставили в покое, но воздействие (агрессивное промо, слишком настойчивое предложение) их раздражает и снижает вероятность платежа.
Таким образом, в таких задачах нужно предсказывать не просто вероятность того заплатит игрок или нет, а P(заплатит | воздействие) − P(заплатит | без воздействия), что и называется uplift (или Individual Treatment Effect, ITE, или Conditional Average Treatment Effect на уровне игрока, CATE). И здесь вам обязательно нужны данные из корректно проведённого рандомизированного эксперимента, где часть игроков должна была получить воздействие (treatment), а часть нет (control). После чего, нужно обучить на них две независимые модели по предсказанию вероятности платежа по одним и тем же признакам. Uplift для конкретного игрока считается как разница предсказаний двух моделей («T-learner» подход). Основная проблема такого подхода в том, что, если признаки слабо связаны с исходом, а обучающих данных немного, то разница двух зашумлённых предсказаний зашумлена ещё сильнее, чем каждое из них по отдельности.
Потренируемся на Python с библиотекой scikit-uplift (sklift).
import pandas as pd
from sklearn.model_selection import train_test_split функция для деления выборки
from lightgbm import LGBMClassifier
from sklift.models import TwoModels обучает две отдельные модели
from sklift.metrics import qini_auc_score
Предполагаем, что df содержит данные завершённого A/B-теста, FEATURES это наши признаки D1-3, treatment = 1, если игрок был в группе с промо-акцией и 0 если в контрольной группе, target = 1, если игрок заплатил в течение периода наблюдения теста, иначе 0.
X = df[FEATURES]
treatment = df['treatment']
target = df['target']
Далее передаем три массива одним вызовом, чтобы train_test_split разрезал их согласованно и строка i в X_train соответствовала той же строке в trt_train и y_train. Аргумент test_size=0.3 указывает, что 30% датасета уйдет на валидацию, а stratify=treatment указывает, что доля treatment/control должна быть одинаковой и в train, и в val, но доля плательщиков там может быть различна.
X_train, X_val, trt_train, trt_val, y_train, y_val = train_test_split(X, treatment, target, test_size=0.3, random_state=42, stratify=treatment)
tm = TwoModels(
estimator_trmnt=LGBMClassifier(scale_pos_weight=19, verbose=-1), обучение модели на строках treatment = 1
Также используем прежний дисбаланс классов (95%/5%=19), хотя если promo-акция реально работает, то доля плательщиков внутри группы treatment и внутри группы control не обязана совпадать.
estimator_ctrl=LGBMClassifier(scale_pos_weight=19, verbose=-1), обучение модели на строках treatment = 0
method='vanilla') указание на простой T-learner
tm.fit(X_train, y_train, trt_train)
uplift_val = tm.predict(X_val) предсказанный uplift как P(заплатит | воздействие) − P(заплатит | без воздействия) для каждого игрока на валидации
Qini-коэффициент показывает, насколько хорошо ранжирование по uplift выделяет реальных сегмент “Восприимчивых”
qini = qini_auc_score(y_val, uplift_val, trt_val)
print(qini)
Отсортировав по убыванию игроков по uplift_val, вы получаете приоритизированный список тех кому показывать акцию в первую очередь.
В разделе про A/B-тест на смешанной аудитории мы уже разбирали, что рандомизация честно даёт вам средний эффект (ATE) по всей смеси сегментов, но скрывает, что на разных сегментах эффект может быть противоположным по знаку. Тогда единственным инструментом был сегментный анализ по заранее выбранным вручную сегментам (платформа, гео, платёжный статус). Здесь вы просите алгоритм самостоятельно найти, для кого разница между воздействием и его отсутствием максимальна, используя все признаки сразу, а не только те несколько, что вы выбрали заранее.
4.3.3. LTV-кривая длиной в жизнь игрока
Рецепт Голема-Линии Жизни не сложен: «Этому Голему не нужно множество примеров чужих жизней, ему нужна форма общей судьбы». На странице один-единственный контур: плавная кривая, взлетающая быстро вначале и медленно выравнивающаяся к горизонту.
Голем-Предсказатель судеб из прошлого раздела предсказывал для каждого игрока некоторую численную вероятность заплатит ли этот конкретный игрок в будущем. Голем-Линии Жизни отвечает на другой вопрос: «сколько в сумме принесёт средний игрок этой когорты, если подождать достаточно долго». В обоих случаях мы предсказываем некоторое число, но это разные подходы. Ранее мы обучали модель на множестве примеров вида «признаки игрока → метка плательщик/неплательщик» и тысячам строк, каждая про одного человека. Здесь мы делаем нечто иное: подгоняем одну параметрическую функцию под заданную кривую LTV одной когорты во времени. Наблюдения в привычном смысле здесь не тысячи индивидуальных игроков, а набор точек для графика f(x), где x это день жизни когорты. Здесь нет поиска закономерности среди множества людей, тут нужен подбор формы одной аппроксимирующей кривой.
Ранее в главе про метрики мы рассмотрели модель экспоненциального распада, как фундаментальную модель природы, которая описывает в том числе и отток игроков. В результате чего кривая LTV (в общем случае определяемая как ∫ ARPU(t) · R(t) dt), например, для двух сегментов (казуальных и хардкорных игроков) может выглядеть как сумма из двух уравнений:
LTV = ∫ ARPU ₁ [α·e^(−k₁t)] dt + ∫ ARPU ₂ [(1−α)·e^(−k₂t)] dt .
Вместе с этим, возможен вариант степенной кривой LTV вида
LTV(t) = a · t^b.
При условии, что b находится от 0 до 1 у LTV будет замедляющийся рост, в отличие от модели экспоненциального распада. Степенная функция может лучше описывать игры с длинным циклом жизни когорты регулярных плательщиков, которые продолжают заметно платить даже спустя год и примерно с одним ритмом.
Потренируемся в коде на Python, используя метод из библиотеки scipy
import numpy as np
import pandas as pd
from scipy.optimize import curve_fit
Задаем саму функцию модели, например, формулу насыщающейся экспоненты в виде кода.
def ltv_curve(t, a, b):
return a * (1 - np.exp(-b * t))
Загрузим данные по дням и накопленным ARPU на каждый из них (кумулятивная сумма выручки на пользователя). В данном примере я использовал мало точек, и они неравномерно расположены по оси времени.
t = np.array([1, 3, 7, 14, 30, 60, 90])
cum_arpu = np.array([12.4, 28.1, 51.3, 79.8, 118.2, 148.6, 164.9])
Делаем аппроксимацию при помощи функции curve_fit и находит такие a и b, при которых сумма квадратов отклонений модели от факта минимальна (метод наименьших квадратов). Также задаем стартовое приближение параметров в виде p0, где a можно задать заведомо выше последней наблюдаемой точки (потолок кривой ещё не достигнут по определению). А pcov это ковариационная матрица оценённых параметров, из её диагонали можно получить стандартные ошибки для расчета параметров a и b.
popt, pcov = curve_fit(ltv_curve, t, cum_arpu, p0=[200, 0.05])
a_fit, b_fit = popt
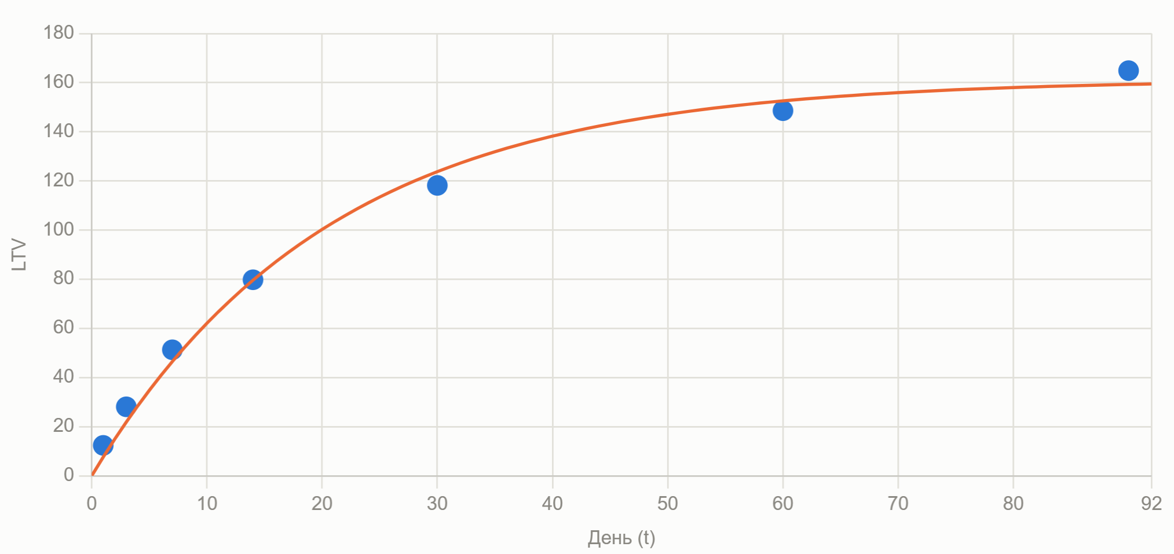
В нашем примере a это примерно 161,3, b примерно 0,0486. Далее экстраполируем на D180 и D360.
t_forecast = np.array([180, 360])
ltv_forecast = ltv_curve(t_forecast, a_fit, b_fit)
Для достоверной аппроксимации нужно много точек на достаточно большой выборке. Часто бывает, что если строить аппроксимацию на маленьких сегментах (сотни, а не тысячи игроков), то единичный кит способен исказить всю форму кривой. Кроме того, метод плохо работает для новых игр, где просто ещё не накопилось истории. И, конечно, метод чувствителен к структурным изменениям в игре. Если между D30 и днём прогноза вышло большое обновление экономики, период больших акций и распродаж, то форма кривой для новых когорт может радикально измениться, но в модель это не попадет пока вы не переобучите ее на свежих данных.
4.3.4. Найди похожих игроков
Это рецепт Голема-Звездочёта: «Ночное небо наполнено бесчисленными звёздами, всмотрись в его бескрайнюю глубину. Звёзды очень разные, но присмотрись, пойми их суть, и ты заметишь, что некоторые из них чем-то похожи. Научись находить в ночном небе новые созвездия и дай им имена».
Ранее в главе про искусство исследований мы уже рассмотрели ценность поведенческой сегментацией. Но если раннее мы сами могли выбрать некоторые границы сегментов экспертно, то алгоритм кластеризации ищет структуру сам, без учителя (unsupervised learning). Вы не задаете правила заранее, кого мы считаем вовлеченным игроков, а кого уставшим от игры, вы даёте алгоритму признаки всех игроков и просите найти естественные группы, а имена этим группам придумываете уже вы сами, глядя на то, что получилось.
Что значит «похожие» игроки? Они могут быть похожи по одному из признаков, но по-другому отличаться, и какую степень отличия мы считаем по каждому признаку допустимой, а какую значимой? Эти вопросы основная причина получить бесполезную кластеризацию. Например, вы кластеризуете игроков по двум признакам: «число сессий за 30 дней» (диапазон от 0 до 500) и «доля платящих дней» (диапазон от 0 до 1 то есть 100%). Один из алгоритмов кластеризации k-means работает так, что меряет «расстояние по метрике» между игроками, и в таком расстоянии разброс в 500 единиц по первому признаку получается гораздо значительнее разброса в от нуля до 1 по второму и, фактически, кластеризация произойдёт только по числу сессий, а доля платящих дней не внесёт в результат почти никакого вклада, хотя содержательно может быть даже важнее.
Поэтому обязательный шаг перед обучением это масштабирование признаков. StandardScaler приводит каждый признак к среднему 0 и стандартному отклонению 1 (вычитаем среднее, делим на σ), MinMaxScaler сжимает каждый признак в диапазон [0, 1]. Для кластеризации на признаках с выбросами StandardScaler уязвим к тем же самым выбросам, которые растягивают саму σ, и на практике часто лучше работает RobustScaler, который масштабирует по медиане и межквартильному размаху, а не по среднему и стандартному отклонению.
Стоит сказать, что если признаков у вас не 5, как в учебном примере, а 100 или более, как часто бывает в реальных задачах то можно дополнительно использовать метод снижения размерности перед кластеризацией, например, через PCA (метод главных компонент). У k-means есть «проклятие размерности», когда чем больше признаков, тем менее осмысленным становится расстояние между точками, а сильно коррелированные между собой признаки (например, «число сессий» и «число дней с активностью» почти всегда коррелируют) начинают неявно задваивать свой вес в общей метрике расстояния. PCA сжимает признаковое пространство в несколько главных компонент, и кластеризация часто получается устойчивее. Однако, после такого преобразования вы теряете прямую интерпретируемость различий между кластерами.
Кроме того, некоторые признаки могут вообще не иметь «расстояния» поскольку не являются числовыми. Например, если в игре есть несколько классов, то один из них не может быть в 2 раза лучше или в 2 раза хуже другого класса. Для таких случаев вам может пригодится, например, GearScore или ГС в ММО РПГ, который оценивает силу и крутость всей экипировки вашего персонажа. В общем случае, есть способы кодирования не числовых признаков, условно для «синего» и «зеленого» или «маленького» и «большого», но на практике в случае применения k-means для кластеризации лучше избегать таких признаков.
Ключевой вопрос кластеризации и k-means, в частности, это сколько кластеров просить искать у алгоритма. Максимальное число кластеров будет равно числу записей (каждому игроку свой кластер), но такая разметка будет совершенно бесполезна. Обычный инструмент выбора числа кластеров это «метод локтя» (elbow method). Упрощенно говоря, «кластеры» это когда ваши игроки сосредоточены вокруг центра кластера и расстояние до центра для них ближе, чем до центра другого кластера.
Сам метод работает следующим образом.
1. Для каждого кластера k считается инерция (within-cluster sum of squares, WCSS) это сумма квадратов расстояний от каждой точки до центра её кластера.
2. С ростом числа k инерция всегда монотонно падает (в пределе, при k равном числу игроков, инерция равна нулю ведь каждый в своём кластере), но падение происходит неравномерно: сначала резкое, затем всё более пологое.
3. Точка, где график «сгибается» и дальнейший рост k почти не даёт выигрыша, и есть кандидат на разумное значение выбора числа кластеров, отсюда и метафора локтя.
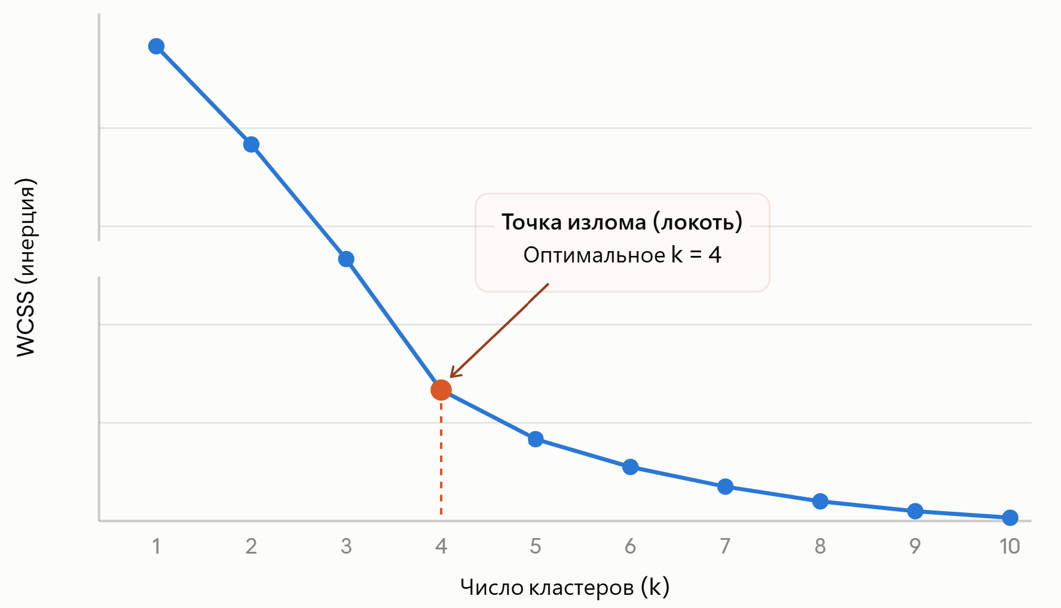
Но метод локтя субъективен и не всегда «сгиб» очевиден на глаз. Более строгая альтернатива это silhouette score, число от −1 до 1, оценивающее для каждой точки, насколько она ближе к своему кластеру, чем к соседнему; усреднённый по всем точкам silhouette score можно сравнивать между разными k напрямую, без разглядывания графика.
Потренируемся в коде на Python, используя метод из библиотеки sklearn
import pandas as pd
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
Готовим матрицу признаков, среди них может быть, например, давность последнего визита, частота сессий, сумма платежей, среднее время сессии, глубина прогресса в игре и т.д..
FEATURES = ['recency_days', 'sessions_30d', 'total_revenue_30d', 'avg_session_length', 'progress_level']
X = df[FEATURES].copy()
Масштабируем признаки.
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
Строим график локтя: цикл по кандидатам k, для каждого обучаем KMeans и записываем инерцию.
inertias = []
for k in range(2, 10):
km = KMeans(n_clusters=k, n_init=10, random_state=42)
km.fit(X_scaled)
inertias.append(km.inertia_)
n_init=10 заставляет KMeans запуститься 10 раз с разными случайными начальными центрами и выбрать лучший результат. Поскольку сам алгоритм чувствителен к точке старта то он иногда может застрять в неудачном локальном минимуме при однократном запуске.
По графику, который был построен ранее, мы выбрали k=4. Обучаем финальную модель.
final_k = 4
kmeans = KMeans(n_clusters=final_k, n_init=10, random_state=42)
df['cluster'] = kmeans.fit_predict(X_scaled)
Проверим как распределены наши признаки по кластерам на основе средних значений исходных (немасштабированных!) признаков по каждому кластеру. Именно эта таблица, а не координаты центроидов в масштабированном пространстве, и станет языком, на котором вы будете объяснять кластеры геймдизайнерам или маркетингу.
cluster_profile = df.groupby('cluster')[FEATURES].mean()
Обученный без учителя алгоритм честно раскладывает игроков по похожести, но «похожесть» это то, что вы разрешили ему измерять набором признаков и их масштабом. Проверьте кластеризацию по критериям применявшимися нами ранее для вручную сделанных сегментов.
- Устойчивость во времени. Постройте матрицу перехода игрока между кластерами месяц к месяцу. Если игроки хаотично скачут между кластерами без видимой причины, кластеры описывают шум, а не устойчивые типы поведения.
- Различия по бизнес-метрикам. Кластеры должны заметно различаться по LTV, Retention, ARPU и не только по центроидам в признаковом пространстве, которые их и породили. Кластеризация, не расходящаяся по деньгам или удержанию, продукту не интересна, какой бы математически элегантной она ни была.
- Интерпретируемость. Может ли наш «Голем-Звездочёт» объяснить геймдизайнеру кластер одним предложением? «Это игроки, которые заходят редко, но привыкли платить за свой комфорт - мало сессий, но высокий средний чек». Если кластер описывается только длинным списком средних по шести признакам без внятной истории за ним, кластеризация красивая, но бесполезная.
-Прогнозная сила. Кластер, в который игрок попал в момент t, должен что-то говорить о его поведении в t+30, а иначе это слепок его текущего состояния, а не сегмент, на основе которого можно строить дальнейшие продуктовые решения.
4.3.5. Каким был бы мир без твоего участия
Голем-Летописец покажет вам мир, который благодаря вам уже не наступит. Этот Голем показывает каким бы сейчас был мир, если бы вы остались в стороне простым наблюдателем. Так вы увидите последствия своих решений.
Ранее мы уже разбирали, что в геймдеве честный A/B-тест не всегда возможен: системные эффекты, сетевые взаимодействия между игроками, глобальные Ивенты, запуск фичи сразу на всех. Но есть возможность исследовать такие случаи. Идея в том, что модель учится предсказывать метрику до события по историческим данным (и, если есть, по похожим незатронутым группам, платформам, серверам), затем экстраполирует «как будто события не было» на период после и сравнивает эту синтетическую линию с фактом. Разница между фактом и синтетическим прогнозом и есть оценка эффекта.
Самая простая реализация идеи, когда модель тренда и сезонности строится на данных до события и продлевается вручную («интерполируется») на период после, без учёта самого события. Если фактическая метрика после события заметно отклоняется от продлённого тренда, то отклонение это кандидат на эффект. У метода нет ни контрольной группы, ни доказательств, что тренд продолжился бы именно так, если бы не событие. Но это самый простой инструмент анализа.
Знакомый по прошлой главе Difference-in-Differences (разность разностей) опирается на допущение параллельных трендов: если бы воздействия не было, затронутая и незатронутая группы двигались бы параллельно. Ключевая проверка этого допущения это плацебо-тест с фиктивной датой воздействия, когда мы применяем ту же процедуру к периоду, где никакого реального события не было, и убеждаемся, что «эффект» не находится там, где его быть не должно. Если плацебо-тест регулярно находит несуществующие эффекты, само допущение параллельных трендов, скорее всего, не выполняется на ваших данных, и результату доверять нельзя, каким бы значимым он ни выглядел. Обратите внимание, что p-value, доверительный интервал и логика «отклонение от ожидания достаточно велико, чтобы не списать его на случайность» это ровно те же понятия, которые мы подробно разбирали в прошлой главе про A/B-тесты («Пещера Оракула»).
Если простая интерполяция кривой, например в Excel, для вас слишком простой инструмент, а для Difference-in-Differences вам необходима контрольная группа, то CausalImpact это подходящий вам метод, реализованный в библиотеке causalimpact. Алгоритм строит байесовскую структурную модель временного ряда, которая учится на предсобытийном периоде и предсказывает, как выглядела бы метрика, если бы события не было, опираясь на динамику сегмента, которого событие не затронуло.
Рассмотрим пример применения CausalImpact в Python.
import pandas as pd
from causalimpact import CausalImpact
Готовим временной ряд целевой метрики (например, ARPDAU по затронутому сегменту) вместе с контрольными сегментами по регионам или платформам, которые не были затронуты ивентом. Контрольные сегменты не обязательны, но именно они дают модели информацию о фоновых колебаниях, не связанных с вашим событием, и заметно повышают точность синтетического прогноза.
data = pd.DataFrame({
'y': arpdau_affected, целевая метрика затронутого сегмента
'x1': arpdau_control_region, контрольный ряд: регион, не затронутый событием
'x2': arpdau_control_platform контрольный ряд: платформа, не затронутая событием
})
Задаём границы обучающего и проверочного периодов индексами дат.
pre_period = [0, 59] 60 дней до события
post_period = [60, 89] 30 дней после события
Использованные позиционные номера строк [0, 59] и [60, 89] взяты как пример. Обычно датафрейм проиндексирован реальными датами и границы периодов нужно задавать не номерами строк, а самими датами: например, pre_period = [‘2026-01-01’, ‘2026-08-01’], post_period = [‘2026-08-02’, ‘2026-12-01’].
Строим и запускаем модель. Внутри CausalImpact обучает байесовскую структурную модель временного ряда на pre_period, используя контрольные ряды как предикторы, и получает распределение вероятных значений y на post_period, если бы события не было.
ci = CausalImpact(data, pre_period, post_period)
print(ci.summary()) точечная оценка эффекта, доверительный интервал, p-value
print(ci.summary(output='report')) текстовая интерпретация результата
ci.plot() покажет три итоговых графика: факт vs прогноз, точечный эффект и кумулятивный эффект за период
Первый график «факт vs прогноз» в виде двух линии, расходящихся в точке события, наглядно показывают и величину, и форму эффекта во времени, включая то, затухает он или нарастает.
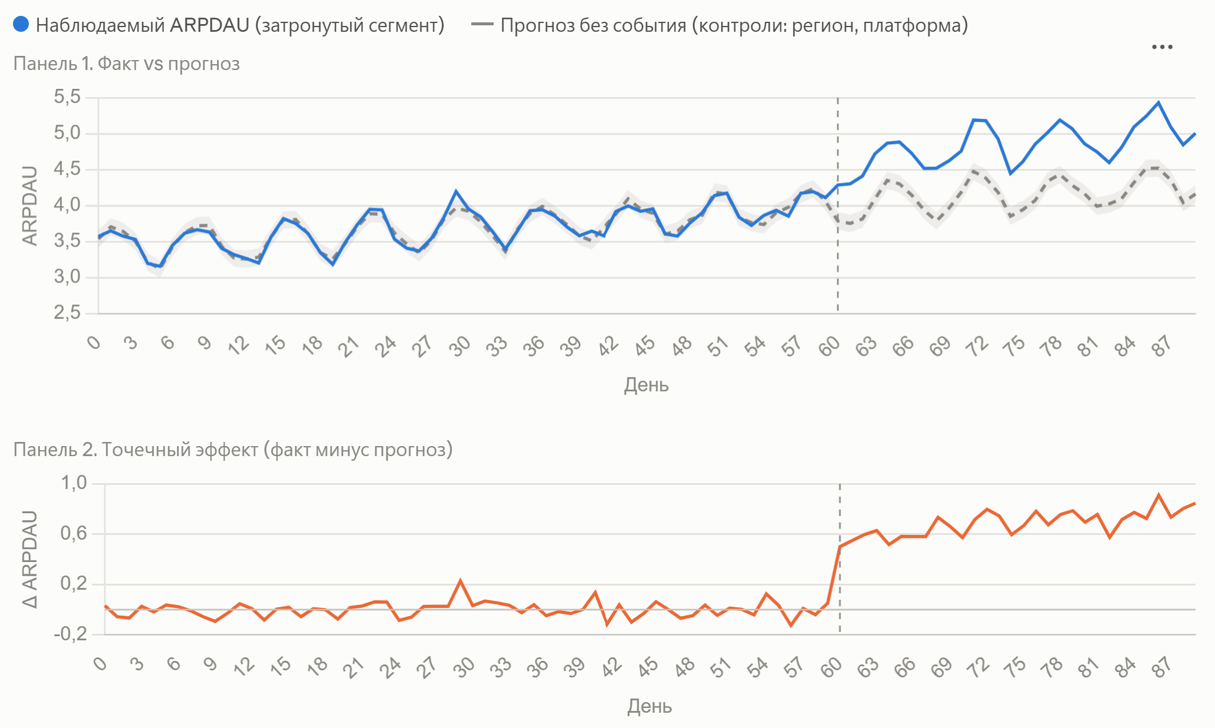
Интерпретация вывода строится вокруг нескольких чисел: точечная оценка эффекта (насколько фактическое значение отличается от прогноза в среднем за период), доверительный интервал этой оценки, кумулятивный эффект и p-value. В нашем примере полученный результат выглядит превосходно. Однако, на практике существует риск спутать реальный эффект с любым другим совпавшим по времени событием: стартом акции или распродажи, обновлением, маркетинговой активностью или сезонным событием.
4.3.6. Каким мир будет дальше
Голем-Пророк чувствует ритм жизни и видит циклы прошлых испытаний и побед. Он слышит дыхание всего мира: как оно учащается по выходным и перед праздником, как замирает после полуночи, как сбивается в дни, когда в мире происходит что-то новое.
Голем-Летописец из прошлого раздела смотрел в прошлое и строил «мир без события», чтобы показать последствия принятых решений. Голем-Пророк прогнозирует каким будет будущее, например, DAU, выручка, объем трафика или другие метрики. Метрики F2P игры почти никогда не выглядят как хаотичные данные, у них обычно всегда есть причина, по которой они или растут или уменьшаются. Для построения прогноза метрики, например, объема входящего трафика обычно нужно выделить тренд, сезональности, значимые календарные события и регрессоры такие как объем маркетингового бюджета. Библиотека Prophet для этого подходит превосходно, запускается обычно без сложных настроек и умеет явно принимать список будущих значимых событий и регрессоров.
import pandas as pd
from prophet import Prophet
Для работы библиотеки необходимо подготовить датафрейм в формате, который ожидает Prophet: колонка ds с датой и колонка y со значением целевой метрики.
df = pd.DataFrame({
'ds': dates, дата, например DAU по дням
'y': dau_values значение метрики
})
Задаём известные заранее ивенты отдельной таблицей, Prophet умеет учитывать нерегулярные, но известные наперёд даты как модификатор тренда вокруг события, а не как обычный шум.
events = pd.DataFrame({
'holiday': 'game_event',
'ds': pd.to_datetime(['2026-02-22', '2026-03-08', '2026-12-31']),
'lower_window': 0, событие влияет начиная с самого дня
'upper_window': 3 и ещё три дня после него
})
Обучаем модель и строим прогноз на N дней вперёд.
model = Prophet(holidays=events, weekly_seasonality=True, yearly_seasonality=False)
model.fit(df)
future = model.make_future_dataframe(periods=30) на 30 дней вперёд
forecast = model.predict(future)
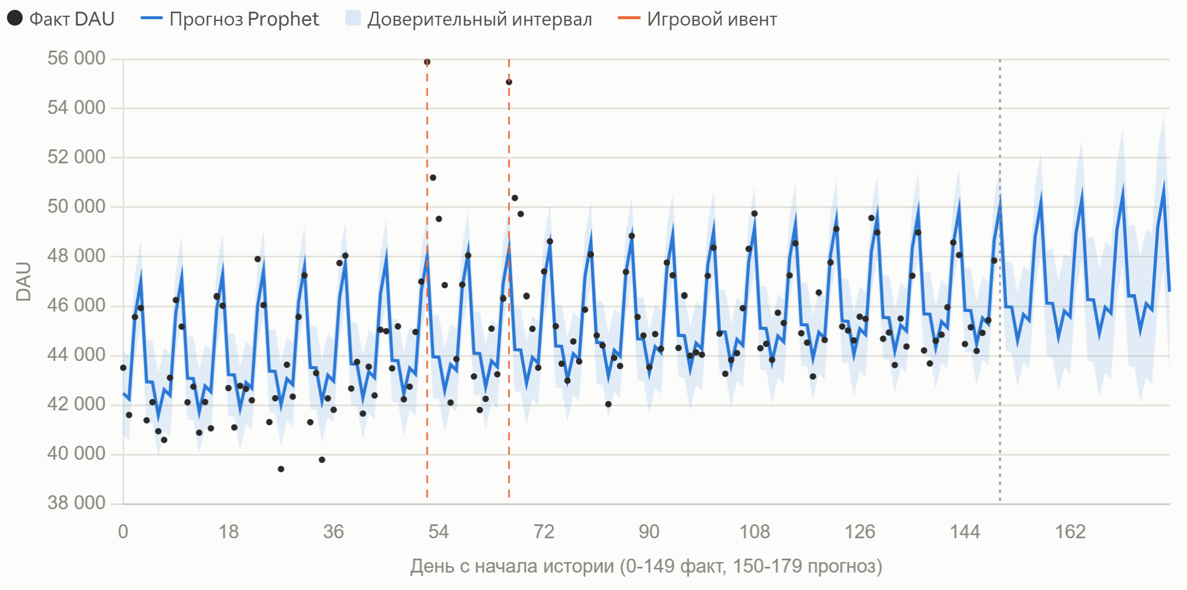
Из дополнительных возможностей Prophet может использовать регрессоры, при подаче которых вам необходимо указать их будущие значения на период прогноза, а также есть возможность ограничить прогнозируемую метрику по ее физическому смыслу, установив нижний и верхний диапазон. Например, если ваша игра близка к насыщению своего рынка, и вы не ждёте бесконечного роста DAU, стоит явно указать Prophet физический потолок метрики через логистический рост вместо линейного.
Зададим верхнюю (cap) и нижнюю (floor) границу, важно, что они должны быть в каждой строке df, включая future
df['cap'] = 500000
df['floor'] = 0
model = Prophet(
growth='logistic', без этого условия и границ Prophet использует линейный тренд
holidays=events,
weekly_seasonality=True,
yearly_seasonality=False
)
model.fit(df) обучаем модель заново
future = model.make_future_dataframe(periods=30) на 30 дней вперёд
future['cap'] = 500000 cap и floor нужно продублировать и в future
future['floor'] = 0
forecast = model.predict(future)
Кроме того, есть способ проверить качество сделанной модели инструментом самого Prophet путем кросс-валидации на нескольких исторических окнах.
from prophet.diagnostics import cross_validation, performance_metrics
Далее initial это сколько данных брать в первое обучающее окно, period это насколько сдвигать окно между проверками и horizon это на сколько дней вперёд прогнозировать в каждой проверке.
df_cv = cross_validation(model, initial='180 days', period='30 days', horizon='30 days')
df_perf = performance_metrics(df_cv)
print(df_perf[['horizon', 'mape', 'rmse']].head())
Логика проверки аналогична holdout-выборке для классификатора. Прежде чем полагаться на прогноз в реальном планировании бюджета или маркетинговых кампаний, проверьте, насколько модель ошибалась на нескольких прошлых окнах, а не только один раз посмотрите на итоговый график.
4.3.7. Ошибки ученика волшебника
Ваша модель на продакшене не остаётся хорошей навсегда. Игра меняется, появляются новые механики, логи для сборки признаков могут изменить содержание или формат, экономика ребалансится и модель, обученная на прошлом, рано или поздно перестаёт соответствовать настоящему. По моему опыту, часто ошибка может заключаться еще и в том, что вы по-разному собираете признаки при обучении модели и на продакшене. При формировании обновляемого пайплайна вы оптимизируете структуру сборки датасета, исходя из ожиданий по надежности, скорости работы и отказоустойчивости при ежедневной работе и, как следствие, неизбежно немного меняете код сборки фичей. Например, вы обучали модель на фиче «число сессий за первые 3 дня», а в проде эта же фича считается в реальном времени и на момент прогноза из-за лага в появлении свежих данных у нового игрока учтено на несколько часов данных меньше, чем было в среднем в обучающей выборке. Модель при этом прежняя, она просто получает на вход данные, систематически отличающиеся от тех, на которых она училась.
Рассмотрим, что может указать вам на нарастание ошибки модели.
- Распределение предсказаний модели по времени (data drift) меняется без видимой причины.
- Реальная точность на свежих данных ухудшается, если сама зависимость между признаками и таргетом изменилась. Модель может исправно получать привычные по распределению фичи, но правило, по которому эти фичи раньше предсказывали платёж, уже не работает, потому что изменилась, например, сама игра. В том случае, если реальное значение метрики можно узнать через длительный период то необходимо мониторить качество прогноза через более ранние прокси метрики.
- Доля пропущенных или аномальных значений во входных признаках на случай проблем с логированием и неверным расчетом признаков.
В целом, можно сформировать план переобучения модели по расписанию или по триггеру, когда, например, метрика упала ниже порогового значения. Обычно новая версия модели работает параллельно со старой на части трафика, прежде чем полностью её заменить. Часто ошибки модели не являются виной самого алгоритма. «Големы» делают именно то, о чём их попросили и опасность в разнице между тем, что было сформулировано, и тем, что было на самом деле нужно, а также в отсутствии заранее указанного условия остановки. Хороший аналитик должен уметь понимать границы возможностей алгоритмов.
4.3.8. LLM как Голем-Собеседник
Старший жрец показал вам лучшее творение волшебника. Голема из глины всех библиотек мира, миллионов свитков, отчётов и подслушанных разговоров жрецов. Голем, который уже не слуга, а собеседник. Он говорит на всех языках, проводит ритуалы быстрее любого подмастерья и никогда не устаёт. Когда он появился, жрецы говорили, что Голем вскоре заменит их всех, поэтому они так сторонились волшебника.
Локальная LLM (LM Studio и Jupyter)
Для многих задач продуктовой аналитики есть ограничения на работу с облачным API, когда работа с персональными данными или критичными для бизнеса метриками подталкивают к локальной модели. LM Studio (это GUI-обёртка поверх llama.cpp) как пример одного из самых простых способов поднять локальную LLM на вашем компьютере: скачиваете бесплатное приложение с официального сайта, выбираете модель подходящего размера под вашу видеокарту (для скромного железа подойдут компактные модели в 4-битном квантовании). Далее запускаете локальный сервер и обращаетесь к нему из Jupyter без счёта за токены и без данных, покидающих вашу машину. Приватность данных и отсутствие затрат на токены это реальный выигрыш локальной модели, но все же он даётся в обмен на качество и скорость.
Локальный сервер. В LM Studio есть вкладка Developer / Local Server: выбираете загруженную модель, жмёте Start Server и поднимается локальный HTTP-сервер (по умолчанию http://localhost:1234/v1), совместимый с OpenAI Chat Completions API. Весь последующий код в Jupyter пишется так, будто вы обращаетесь к OpenAI, просто с другим base_url и без ключа.
Подключение из Jupyter. Самый прямой путь это установить официальный пакет openai.
from openai import OpenAI
client = OpenAI(
base_url="http://localhost:1234/v1",
api_key="not-needed" для локальной модели ключ не требуется
)
response = client.chat.completions.create(
model="local-model", тут указываете имя загруженной модели
messages=[
{"role": "system", "content": "Ты помощник продуктового аналитика в геймдеве, отвечай по-русски, кратко и по делу."},
{"role": "user", "content": "Напиши Jupyter magic-команду для удобного взаимодействия с локальной LLM с сохранением контекста диалога не более 10 сообщений (5 вопросов и 5 ответов), запущенной через LM Studio (локальный сервер, OpenAI-совместимый API, адрес по умолчанию http://localhost:1234/v1, api_key не проверяется). Выведи готовый, рабочий код с комментариями на русском языке. После кода выведи короткий пример использования: одну ячейку с %%golem, где в prompt подставляется df.describe(), и одну ячейку с %golem как однострочный вопрос."}
],
temperature=0.2
)
print(response.choices[0].message.content)
Прикладные задачи для LLM
Поиск аномалий в данных при помощи LLM не должен заменить вам как продуктовому аналитику самостоятельную проверку традиционных статистик, но может быть полезным как второй голос, который просматривает уже посчитанные сегменты и подсвечивает то, что не бросилось вам в глаза с первого взгляда. Потренируемся в написании промта и не будем еще раз прописывать роль, предполагая, что мы указали ее в системном промте.
В активной ячейке подготовлен датафрейм с платежами игроков в мобильной F2P игре. Проанализируй данные строго на основе датафрейма, без выдуманных фактов и без предположений, которые не подтверждаются данными.
Датафрейм содержит следующие колонки:
- дата_платежа - дата совершения платежа,
- размер_выручки - сумма платежа в валюте отчёта,
- arppu_дня - средний чек платящего пользователя за эту дату (ARPPU),
- регион - страна/регион игрока,
- платформа - платформа платежа (iOS / Android / Web),
- название_игры - идентификатор игры.
Найди и опиши
1. Пропущенные значения по колонкам.
2. Дубликаты платежей по transaction_id.
3. Строки с отрицательной или нулевой выручкой (учти, что отрицательная выручка может быть легитимным возвратом денег, а не только ошибкой. Не делай вывод об источнике без подтверждения в данных).
4. Даты, которые выбиваются из общего периода наблюдения, а также даты в будущем относительно последней даты в датафрейме.
5. Аномально большие значения размера выручки или arppu дня, оцени их через межквартильный размах или сравнение с медианой, а не через произвольный порог.
6. Регионы или платформы, отсутствующие в ожидаемом справочнике значений (перечисли уникальные значения по каждой колонке, если среди них есть похожие друг на друга варианты написания одного и того же региона/платформы, например, разный регистр или пробелы).
7. Расхождение arppu_дня с расчётным (размер_выручки / число уникальных платящих в этот день, если такое число можно получить из данных). Отметь, если такое сравнение сделать нельзя из-за отсутствия идентификатора платящего игрока в датафрейме.
Для каждой найденной проблемы покажи: сколько таких строк (абсолютное число и доля от общего числа строк), почему это может быть проблемой именно в контексте продуктовой аналитики F2P игры (например, влияние на расчёт ARPU/ARPPU, риск задвоения выручки в отчёте, риск учесть тестовые/QA-платежи как реальные). Не делай общих выводов вида «данные качественные» или «данные плохие», только перечисление конкретных находок с числами.
Как вы видите в этом примере описание промта очень подробное, как будто вы говорите с джуном или даже стажером. Но это поможет снизить вероятность галлюцинации LLM, ведь «Голем Собеседник» старается вам понравится своим ответом, и делает именно то, о чём его попросили, а не то, что было на самом деле было вам нужно.
Написание кода для тестирования качества логов также хорошая задача для LLM, когда вам нужно регулярно по шаблону писать однообразный, но нужный код для проверки на дубликаты event_id, неожиданные NULL в обязательных полях или пропуски. Но помните, что код от модели работает как черновик, который вы проверяете и запускаете сами, а не вставляете в пайплайн вслепую. Для задачи написания LLM кода системный промт можно заменить на Ты опытный Python-разработчик, специализирующийся на data quality для аналитических пайплайнов.
Продолжим тренироваться на промтах для нашего «Голема».
Напиши функцию на pandas, которая проверяет качество сырого лога игровых событий мобильной F2P игры. Датафрейм событий содержит колонки:
- event_id - уникальный идентификатор события.
- user_id - идентификатор игрока.
- session_id - идентификатор игровой сессии.
- event_ts - таймстамп события (unix time, миллисекунды).
- install_ts - таймстамп первой установки игрока (unix time, миллисекунды).
- event_name - название события (строка).
- app_version - версия клиента игры (строка, например “2.14.3”).
- platform - платформа (iOS / Android).
- params - сырые параметры события в виде JSON-строки (может быть NULL).
Функция должна называться check_event_log_quality(df, allowed_events, days_window=30) и принимать:
- df - датафрейм событий,
- allowed_events - список допустимых значений event_name,
- days_window - сколько последних дней считать валидным диапазоном для event_ts.
Проверки, которые должна выполнять функция:
1. Дубликаты по event_id - полные дубли строк с одинаковым event_id.
2. event_ts вне диапазона последних days_window дней от текущего момента, а также event_ts в будущем относительно текущего момента.
3. event_ts раньше install_ts - событие, случившееся до установки игры, технически невозможно и указывает на баг клиента или рассинхрон часов устройства.
4. event_name вне списка allowed_events.
5. Пропуски (NULL) в обязательных полях: event_id, user_id, event_ts, event_name.
6. Дубли по double-fire: одинаковые (user_id, event_name, params) с разницей event_ts менее 1 секунды — типичный симптом повторной отправки одного и того же события клиентом при плохом соединении, а не два разных реальных события.
7. Некорректный JSON в колонке params - строки, которые не парсятся json.loads, при этом сама колонка не NULL.
8. session_id, который встречается у разных user_id - потенциальный признак коллизии идентификаторов сессии.
Функция должна вернуть словарь, где ключ это название проверки, а значение это датафрейм со строками, нарушающими эту проверку (не просто количество, а именно сами проблемные строки, чтобы их можно было исследовать дальше). Дополнительно напиши отдельную функцию summarize_quality_report(report_dict, total_rows), которая по словарю из check_event_log_quality печатает сводную таблицу: название проверки, число найденных строк, доля от total_rows в процентах.
Требования к коду:
- используй векторизованные операции pandas, избегай построчных .apply там, где возможно (например, для JSON-парсинга .apply неизбежен, но нужно обернуть каждый вызов в try/except внутри, а не ронять всю функцию на первой же битой строке);
- работай с event_ts и install_ts как с числовыми unix-таймстампами в миллисекундах, конвертируй в pd.Timestamp только там, где нужно сравнение с датами;
- добавь комментарии на русском языке к каждому нетривиальному шагу;
- не изменяй исходный датафрейм df, все операции должны быть на копиях или через булевы маски без мутации входных данных.
После кода приведи пример вызова функции на игрушечном датафрейме из 5–6 строк, где явно присутствуют примеры нарушений каждого типа, и покажи, как выглядит вызов summarize_quality_report на результате.
Генерация первого драфта аналитического отчёта при помощи LLM также возможна, но по уже посчитанным вами цифрам, а не выдуманным моделью на лету. «Голему-Собеседнику» можно доверить сделать первую интерпретацию ваших результатов, превратить ваши цифры в связный текст и подсветить на что вам стоит обратить внимание. Но если вы дадите ему возможность строить статистики самому, то вы рискуете получить, например, уверенно звучащий отчёт с тихо переставленными местами процентами. Попробуем сформулировать промт для нашего «Голема» как подробную инструкцию для джуна и вначале добавим ему роль.
Ты продуктовый аналитик, помогающий составить черновик аналитического отчёта. Ниже приведены уже посчитанные аналитиком цифры и таблицы по проведённому анализу. Все расчёты выполнены заранее и твоя задача не пересчитывать и не проверять арифметику, а превратить готовые цифры в связный текст отчёта и подсветить, на что аналитику стоит обратить внимание перед тем, как показывать отчёт команде разработки игры. Пиши по-русски, деловым языком.
Контекст:
- Цель анализа: {…}
- Период наблюдения: {…}
- Сегмент аудитории: {…}
- Известные ограничения выборки или методологии: {…}
Посчитанные данные: {ваши таблицы и метрики}
Строгие правила:
1. Используй только цифры, приведённые выше. Не изобретай, не округляй в свою пользу и не подставляй правдоподобные, но не данные тебе значения.
2. Если для содержательного вывода не хватает данных, то прямо напиши, каких данных не хватает, вместо того чтобы додумать вывод.
3. Не утверждай причинно-следственную связь как факт, если это не следует напрямую из метода анализа.
4. Если в цифрах есть внутреннее противоречие или то, что выглядит подозрительно (аномально высокая метрика) то не сглаживай это, а вынеси отдельным пунктом как то, что стоит перепроверить перед публикацией отчёта.
5. Не используй фразы вида «результаты показывают значительный рост» без указания конкретного числа и его значимости. Каждое качественное утверждение должно быть привязано к конкретной цифре из входных данных.
Структура итогового черновика отчёта:
1. Резюме (2–4 предложения). Что было проверено, что получилось, можно ли действовать на основе результата прямо сейчас.
2. Ключевые цифры. Перечисли основные метрики из входных данных в читаемом виде (не таблицей, а связным текстом), без интерпретации.
3. Интерпретация. Что эти цифры означают для продукта, опираясь строго на данные и контекст, без домыслов сверх них.
4. На что обратить внимание. Отдельным списком укажи любые аномалии, недостаточность данных, риски интерпретации, методологические ограничения, которые ты заметил в приведённых цифрах или контексте.
5. Бизнес-гипотезы (не менее 3).
Для каждой гипотезы укажи:
- формулировку гипотезы;
- на какие конкретно данные из приведённых выше она опирается;
- как её можно дополнительно проверить;
- какие дополнительные данные для этого нужны;
- какое бизнес-решение может быть принято, если гипотеза подтвердится.
Не утверждай причину как факт, если в данных нет прямого подтверждения, формулируй как гипотезу, а не вывод.
6. Рекомендуемые следующие шаги. Предложи конкретные действия: доснять данные, перепроверить конкретную аномалию, запустить дополнительный тест, либо предложение по продуктовому решению.
Вам решать каким будет ваше путешествие
Это путешествие вас как Героя Легенд ценно не прибытием к финалу истории, а тем, что происходит с вами в этой дороге и тем, каким вы станете по завершению всего курса. Так Бильбо, ушедший из Шира, и Бильбо, вернувшийся, уже был не один и тот же хоббит. Голем-Собеседник может быть вашим спутником: он несёт часть поклажи, подсказывает, где брод, будит вовремя, если вы проспали свою стражу у костра, но каждый шаг между дверью и драконом настоящий Герой Легенд всё равно делает сам, ногами, через усталость и страх. Голем-Собеседник может сделать за вас всю работу: привезти вас к горе и вернуть обратно, убить за вас дракона, добыть вам сундук с сокровищами. Снаружи такие истории могут быть неотличимы и в обеих версиях какой-то код напишется, метрики соберутся, задачи будут закрыты, отчёты представлены. Разница в том, что во второй версии путешествия не будет Вас как Героя. И проявится это на первой задаче, где Голем уверенно свернёт не туда, а проверить будет некому, потому что вы никогда не проходили эту дорогу сами.
Вы продуктивны с первой недели: SQL пишется, дашборд собирается, в три часа ночи есть собеседник, который объяснит дельта-метод терпеливее любого ментора. Исчез самый изматывающий участок старой дороги «я третий день ищу ошибку в коде и чувствую себя идиотом». Вместе с Големом доступ к экспертизе перестал зависеть от лотереи «достался ли тебе хороший наставник» и это отлично. Проблема в том, что скорость закрытия задач и скорость становления вас как Героя Легенд это разные величины, и Голем-Собеседник по умолчанию оптимизирует первую за счёт второй.
Эта цифра не может быть правдой. Вся диагностическая интуиция, когда вы видите, что «это слишком красиво для правды», или «такого ARPPU не бывает в природе» работают на основе ваших шрамов от пережитых лично сражений и восхождений на вашем пути.
Этот запрос нужно переписать. Сколько строк должно вернуться после этого JOIN? В чем ошибка в логике этого запроса? Из каких таблиц можно дополнительно проверить эти данные? Если запрос крутится минуту вместо секунды это норма или проблема? Как оптимизировать пайплайн чтобы в итоге он не падал? Аналитик, писавший сложные запросы руками, отвечает уже рефлекторно.
Иллюзия компетентности. Кажется, что если снаружи не видно разницы, то зачем проходить этот сложный путь самому. Вы искренне считаете, что умеете делать анализ, потому что дашборды и отчеты у вас принимают. Это не самообман, это просто ошибка калибровки, когда у вас нет реального сигнала о ваших умениях в потоке шаблонных задачах. Любая нестандартная ситуация и вам все сразу станет ясно. Если все что вы можете это только делать с Големом задачи уровня джуна, то не удивляйтесь, когда Голем заменит вас в этой компании.
Вы уходите из Пешеры Оракула и мастерской Волшебника со знаниями о священном ритуале и с Гримуаром Големов. Вы знаете, что Голему можно отдать любую задачу, кроме одной. Никто другой не пройдет за вас вашу дорогу приключений. Впереди вас ждет раздел про искусство влияния. Потому что даже самый точный прогноз бесполезен, если вы не умеете убедительно и честно донести его до тех, кто принимает решение о том, что делать дальше.